发布时间:2026-08-06
2026年8月6日,原中国科学院脑科学与智能技术卓越创新中心孙强研究团队与上海交通大学Bio-X研究院毛亚飞课题组合作,在Cell 期刊上发表了题为 Complex subtelomeric architectures in a complete rhesus macaque reference genome的论文。该研究通过开发并优化高度重复序列的组装策略,成功发现并系统解析了以SATR为代表的卫星重复序列,进而构建了首个达到“近乎完美”标准的灵长类参考基因组。研究首次揭示了猕猴属特有的亚端粒复杂结构及其演化形成,提示了重复序列在染色体末端结构塑造中的重要作用,并在这些重复区域中发现了具有转录证据的基因拷贝。进一步地,研究利用该基因组显著提升了群体遗传学分析和单细胞多组学解析的准确性与分辨率,为非人灵长类动物模型构建、基因组演化以及演化医学等研究建立了关键遗传参考基础。
1. 长读长测序平台的测序偏倚
亚端粒等高度重复区域的完整组装,是基因组学长期以来最难突破的技术瓶颈之一。长读长测序平台凭借跨越大尺度重复序列的能力,已成为构建完整基因组的核心支撑。然而,即使读长足够覆盖复杂区域,不同测序平台仍可能受到序列组成和重复结构的影响,产生系统性的测序偏倚。这些偏倚在常规区域中并不显著,却会在高度重复区域持续累积,成为基因组从“无缺口”迈向“高准确度”的主要障碍。
该研究系统归纳了长读长测序在复杂重复区域中普遍存在的四类偏倚:
测序深度缺失:某些基因组区域的测序读段覆盖显著低于预期或完全缺失,表明现有测序化学体系或一致性序列生成算法尚难以稳定解析此类序列。下文所述的SATR卫星阵列正是其中的典型代表。
同聚物错误:当相同碱基连续出现时,测序平台容易错误判断碱基重复的实际长度,产生插入或缺失。
链方向偏倚:同一区域中正向与反向比对读段对部分碱基的支持呈系统性差异,造成方向依赖的碱基判定偏差。
特定序列上下文错误:某些序列组合或重复基序容易产生稳定的碱基识别错误。例如,团队在190个串联重复位点观察到ONT读长中一致出现“GGG”缺失,而Illumina短读长的k-mer证据不支持这一结果,提示其可能是ONT在特定序列背景下产生的系统性错误。
需要指出的是,这四类偏倚并非相互独立。特定序列背景既可能直接诱发稳定的识别错误,也可能与同聚物错误或链方向偏倚叠加,进一步增加复杂重复区域组装和校正的难度。
针对大尺度重复区域中常见的序列折叠与错误组装,研究团队基于ONT数据构建稀疏de Bruijn图,通过锚点定位、图结构剪枝和路径解缠,恢复相应区域的正确组装路径;随后结合局部参考锚定的k-mer图与短读长招募策略,对复杂区域进行单碱基层面的精细校正。
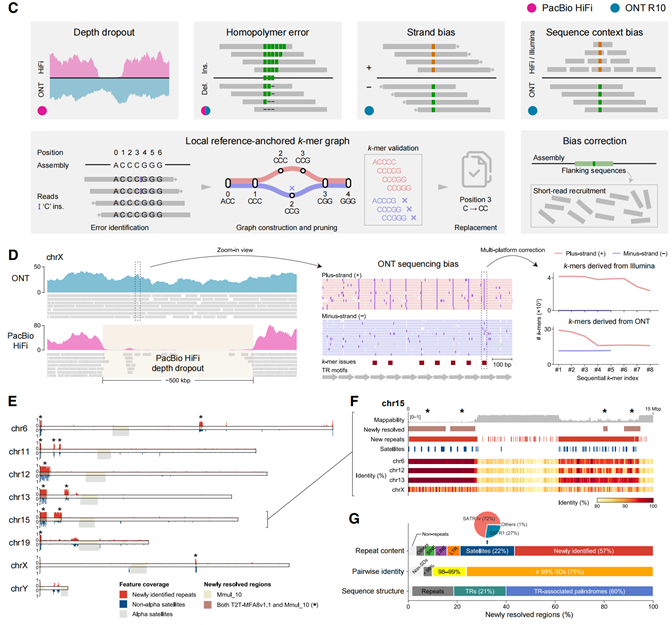
图1 长读长测序偏倚与复杂重复区域的解析
基于上述策略,研究团队构建了完整且近乎完美的恒河猴参考基因组T2T-MMU8v2.0。该基因组呈现均一的测序深度,基因组连续性指标GCI达到100,并在k=21下获得Merqury估算QV100。研究团队在T2T-MMU8v2.0中鉴定出268个此前未被注释的重复序列家族,为研究灵长类复杂基因组区域的结构组成、潜在功能及演化差异提供了高质量参考。
2. 猕猴属亚端粒序列结构构型与表观特征
亚端粒是紧邻端粒、连接染色体特异性序列与末端重复序列的过渡区域,通常由片段重复和卫星序列交错组成,并可通过复制、易位及异位重组持续演化。因此,亚端粒在不同个体和物种间往往具有较高的拷贝数与结构多样性,既可能为基因家族的扩增和分化提供序列基础,也可能增加染色体末端发生异常重排的风险。然而,高度相似的片段重复和长串联卫星阵列,也使亚端粒成为长期难以解析的重复序列聚集地。
研究发现SATR是猕猴基因组中的一类未被完整解析的卫星DNA序列,由短重复单元连续排列形成长串联阵列,包括SATR1、SATR1v和SATR2等主要家族。研究团队共解析出约8 Mbp的SATR卫星阵列,发现这些序列虽然也分布于染色体内部,但在染色体p臂亚端粒区域呈约99倍富集。更重要的是,猕猴亚端粒并非卫星序列的无序堆积,而是由SATR混合阵列构成核心,并与片段重复间隔区和复合重复序列按照特定次序排列,形成可重复识别的复合结构。根据SATR家族的组合方式及其侧翼序列组织,研究团队进一步归纳出四类SATR结构构型。这些构型分布于亚端粒及染色体内部位点,表明猕猴基因组中的SATR富集区域并非重复序列的随机堆积,而是具有可识别且相对有序的组织架构。
在序列层面,亚端粒片段重复间隔区的平均一致性达到97.88%,高于染色体内部的同类结构,提示其可能经历了较近期的扩增,或受到染色体末端之间重组和基因转换的影响。在表观遗传层面,不同SATR构型的核心区域整体呈高甲基化状态,但其GC含量随卫星序列组成而有所差异。研究团队还通过荧光原位杂交,在17条染色体的亚端粒区域验证了SATR1信号,进一步支持组装结果及SATR阵列的染色体分布。与非洲类人猿的亚端粒卫星结构相比,猕猴SATR构型在序列组成、结构组织和甲基化模式上均表现出明显差异,反映了灵长类亚端粒结构在不同谱系中的演化分化。
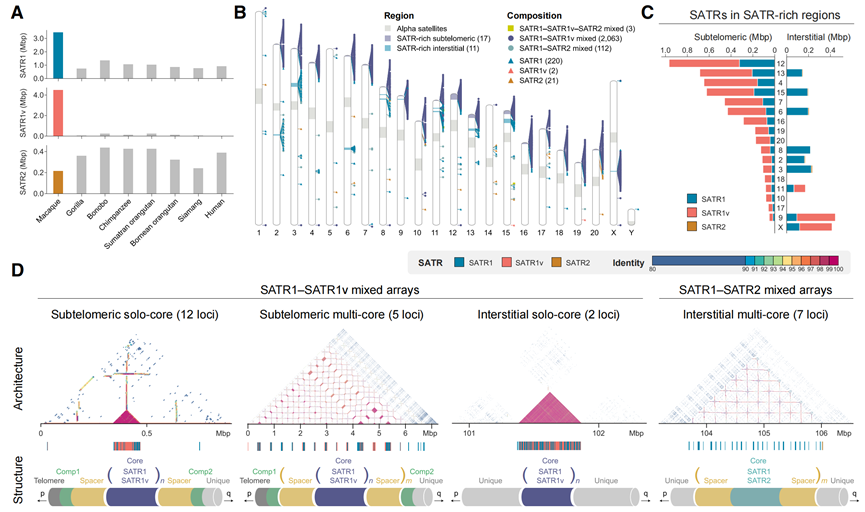
图2 猕猴属亚端粒序列结构特征
3. 高度重复区域的活性基因拷贝
在解析SATR构型的序列组成和组织方式后,研究团队进一步考察了这些高度重复区域中的基因分布与转录特征。T2T-MMU8v2.0恢复了部分在既有参考基因组中因序列缺失或错误折叠而未能识别的基因。比较分析显示,这些新增基因在SATR相关区域显著富集,表明部分重复区域并非“基因荒漠”,而是包含此前难以解析的基因拷贝。
研究团队在SATR相关区域中补充解析出225个基因拷贝,涉及ZNF669、SH3TC1、PFKP和PITRM1等基因。值得注意的是,ZNF669的截断拷贝ZNF669L与亚端粒SATR构型呈现稳定的空间关联:在研究解析的17个亚端粒SATR区域中,每个构型的侧翼边界区域均分布有至少一个ZNF669L拷贝。结合全长转录组和表观遗传数据,其中4个ZNF669L拷贝同时获得全长转录本及活性染色质标记的支持。
在SATR相关区域中,研究团队共发现58个具有转录活性证据的基因拷贝,部分拷贝的转录本还可在前额叶皮层、脾脏和卵巢等多种组织中检测到。这些结果表明,高度重复区域并非完全处于转录沉默状态,并为进一步解析其中基因拷贝的功能潜力及其演化命运提供了候选对象和研究线索。
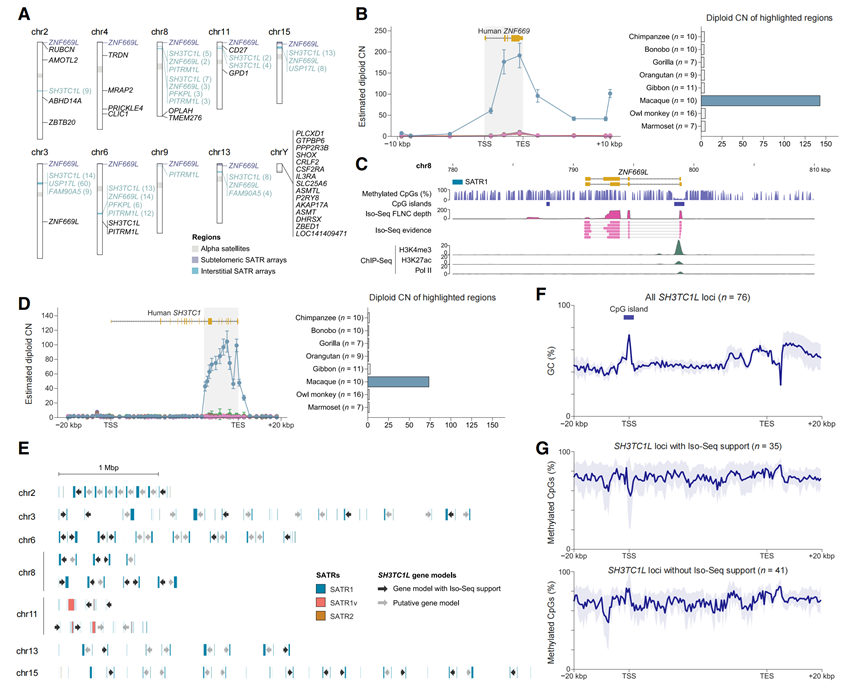
图3 重复序列阵列中的基因家族扩增与转录活性
综上所述,本研究通过优化组装与序列校正策略,有效应对长读长测序偏倚及高度重复区域带来的组装挑战,构建了高准确度且完全连续的恒河猴T2T参考基因组T2T-MMU8v2.0。在此基础上,研究团队系统解析了猕猴SATR卫星阵列在亚端粒及染色体内部的复杂组织构型与表观遗传特征,使以往难以解析的基因组“暗区”获得了更加完整的序列与结构呈现。该实验室的另一项研究还表明,人类2号染色体融合伴随着片段重复和亚端粒重复序列的更替,而相关片段重复在非洲类人猿中的不完全谱系分选可能促进了融合位点的形成。这些发现共同提示,亚端粒重复序列的动态变化可能与灵长类染色体结构演化密切相关,但其具体作用机制仍有待通过更多物种的完整基因组比较和功能研究进一步阐明。
原中国科学院脑科学与智能技术卓越创新中心,现中山大学香港高等研究院/中山医学院孙强与上海交通大学Bio-X研究院毛亚飞为该论文的共同通讯作者。中国科学院脑科学与智能技术卓越创新中心许宁和上海交通大学张世龙为该论文的共同第一作者。本研究与国内外多个灵长类联盟合作,在此感谢联盟内的数据共享支持。
 附件下载: